Ce que Microsoft annonce réellement
Dans son annonce du 12 octobre 2026, Scott Guthrie, responsable Cloud + AI de Microsoft, annonce deux étapes différentes. Maia 200 fonctionne aujourd’hui en production pour des charges de Microsoft Copilot et des travaux de l’équipe Microsoft AI. Maia 300 doit commencer ses déploiements de production en 2027. Confondre ces deux générations reviendrait à présenter une promesse industrielle comme une capacité déjà disponible.
Microsoft prévoit également de porter la famille Azure Maia à des déploiements de plusieurs gigawatts à partir de 2027 et d’en faire le principal système d’inférence de ses produits et services. Le gigawatt désigne ici une échelle de puissance électrique mobilisée par une infrastructure, pas la consommation d’une puce ni la capacité d’un seul centre de données. Le calendrier public ne précise pas combien de sites seront équipés en premier, ni à quelle date le seuil de plusieurs gigawatts sera effectivement atteint.
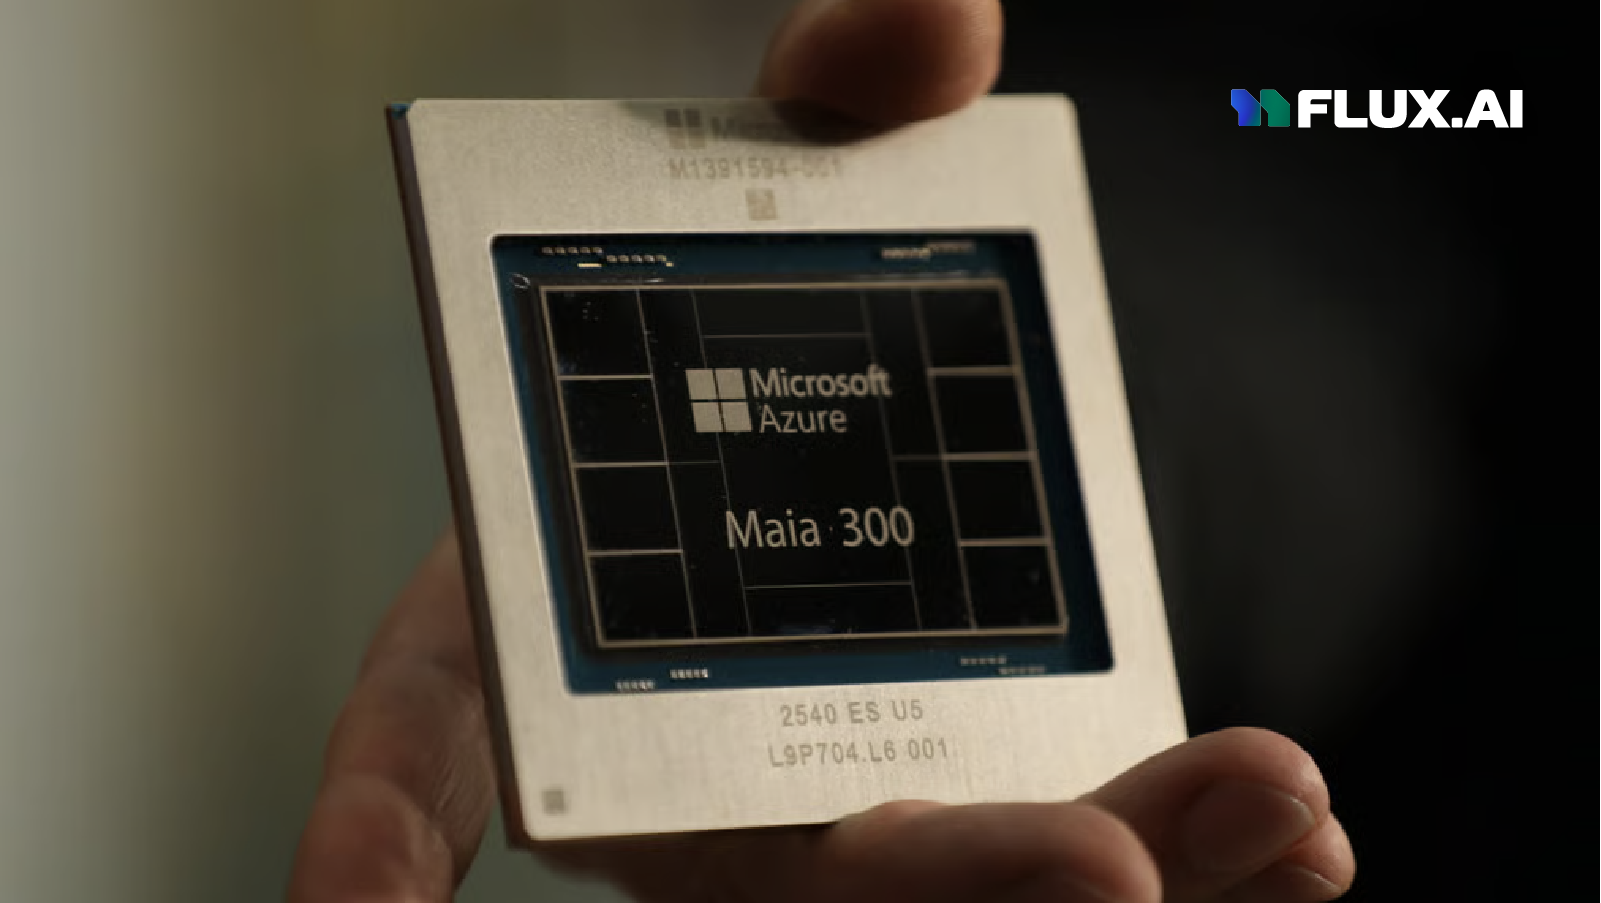
Le groupe présente Maia 300 comme sa troisième génération d’accélérateurs Azure Maia. Son objectif n’est pas de vendre une puce au détail aux particuliers. Microsoft cherche à concevoir, installer et exploiter un système complet : silicium, mémoire, réseau, racks, refroidissement et logiciels destinés à servir les modèles dans son cloud. Cette approche relie directement l’annonce au fonctionnement de Copilot, de GitHub Copilot, de Microsoft Foundry et d’autres services.
Pourquoi l’inférence est le véritable enjeu
L’entraînement d’un grand modèle capte souvent l’attention, mais l’inférence se répète à chaque utilisation : une question dans Copilot, une suggestion de code ou une étape supplémentaire d’un agent. À l’échelle de millions de personnes et de nombreuses entreprises, la facture de calcul ne dépend plus seulement de la création du modèle. Elle dépend aussi du nombre de réponses à produire, de leur longueur et de la rapidité attendue.
Les nouveaux usages compliquent encore ce calcul. Une conversation longue doit conserver et relire du contexte. Un agent peut appeler plusieurs outils, attendre leurs résultats, puis reprendre sa génération. Une application interactive, elle, ne peut pas simplement maximiser le débit global si les réponses arrivent trop tard. Microsoft dit avoir conçu Maia 300 pour ces charges à long contexte, sensibles à la latence et riches en étapes successives.
Dans ce cadre, compter uniquement les opérations de calcul d’une puce est insuffisant. La mémoire doit fournir rapidement les paramètres du modèle et les données de la session ; le réseau doit permettre à plusieurs accélérateurs de travailler ensemble ; le logiciel doit placer les tâches au bon endroit. Si l’un de ces éléments ralentit, ajouter de la puissance arithmétique ne se traduit pas automatiquement par davantage de réponses utiles.
HBM4, chiplets et précision réduite : ce qui change dans la puce
Selon Microsoft, chaque accélérateur Maia 300 dispose de huit piles de mémoire HBM4, pour 288 Go de capacité et jusqu’à 18 To/s de bande passante mémoire. Son enveloppe thermique annoncée est de 950 W. Ces chiffres expliquent une partie du pari : les grands modèles et les longues sessions sollicitent fortement la mémoire, et le débit entre celle-ci et les unités de calcul peut devenir un goulet d’étranglement.
Le décryptage architectural publié par Microsoft Azure décrit une conception à plusieurs chiplets. Les parties dédiées au calcul utilisent le procédé N2P de TSMC ; les contrôleurs mémoire et les fonctions d’entrées-sorties sont séparés. Microsoft indique que cette répartition permet d’adapter chaque fonction à ses contraintes plutôt que d’imposer une seule recette de fabrication à toute la puce.
L’architecture travaille aussi sur la circulation des données. Microsoft décrit une organisation mémoire tenant compte de la proximité entre chaque région de calcul et les données dont elle a besoin, ainsi qu’une mémoire SRAM sur la puce gérée par logiciel. L’objectif est de réduire les déplacements coûteux vers la HBM ou à travers le réseau. L’entreprise met enfin en avant des formats numériques de faible précision, dont une version enrichie de MXFP4, pour diminuer la quantité de données à stocker et à transférer.
Ces choix ne signifient pas que tous les modèles pourront être accélérés de la même manière. La précision acceptable dépend du modèle et de la tâche. La bande passante maximale d’une mémoire n’est pas non plus le débit effectivement atteint par chaque application. Le bénéfice doit être mesuré sur des charges représentatives, avec leurs contraintes de qualité, de latence et de coût.
Un rack de 96 accélérateurs, pas seulement une puce plus rapide
Microsoft annonce un rack Maia 300 regroupant 96 accélérateurs dans une enveloppe électrique de 167 kW. L’ensemble représente 27,6 To de mémoire HBM et 1,7 Po/s de bande passante HBM cumulée, d’après son annonce. Le décryptage technique précise que ces 96 accélérateurs sont répartis dans 24 tiroirs de quatre unités, avec une infrastructure de commutation et de refroidissement conçue autour d’eux.
Ce niveau de densité est important pour l’inférence. Un grand modèle peut être réparti entre plusieurs puces ; de nombreuses requêtes doivent être traitées simultanément ; et les différentes phases d’une réponse n’utilisent pas les ressources de la même manière. Microsoft veut donc améliorer la quantité de travail produite par rack entier et par unité d’énergie, plutôt que d’isoler une mesure spectaculaire sur une seule puce.
Le réseau suit la même logique. Microsoft décrit une interconnexion fondée sur Ethernet, avec un premier niveau à l’intérieur du rack et un second reliant plusieurs racks. Sa présentation technique évoque un « superpod » pouvant atteindre 12 288 accélérateurs, soit 128 racks de 96. C’est une capacité d’architecture annoncée, pas la preuve qu’un ensemble de cette taille tourne déjà en production avec Maia 300.
Une telle échelle ajoute des contraintes rarement visibles dans une fiche de caractéristiques : distribution électrique, refroidissement, disponibilité des composants, tolérance aux pannes et placement des tâches sur le réseau. Le groupe indique que le refroidissement liquide doit retirer plus de 80 % de la charge thermique du rack. L’efficacité promise dépendra donc autant de l’exploitation du centre de données que du silicium lui-même.
Les gains annoncés : des comparaisons à lire avec prudence
Microsoft estime que Maia 300 pourra fournir 40 % de jetons supplémentaires par mégawatt par rapport à des systèmes GPU qu’il qualifie de leaders. L’entreprise annonce aussi jusqu’à sept fois le débit de jetons par rack de Maia 200 dans une configuration complète de 96 accélérateurs. Son billet technique ajoute un gain de plus de 2,5 fois en performance par watt par rapport à Maia 200 à l’échelle du rack.
Ces indicateurs ne sont pas interchangeables. Les « jetons par mégawatt » rapportent une production d’IA à une puissance électrique ; le « débit par rack » mesure une capacité globale ; la « performance par watt » peut dépendre de la charge et du périmètre de mesure. Un rack plus dense peut produire bien davantage de jetons sans que chaque puce soit sept fois plus rapide. Lire le chiffre de sept comme un gain individuel serait trompeur.
Les résultats proviennent pour l’instant de Microsoft. Le groupe ne publie pas, dans son annonce générale, tous les détails nécessaires pour reproduire la comparaison avec chaque système GPU de référence : modèles servis, taille des requêtes, qualité exigée, latence visée, taux d’occupation ou périmètre énergétique complet. Cela ne rend pas les chiffres faux ; cela empêche de les transformer en classement universel et indépendant.
Maia 200 fonctionne déjà : ce que l’on peut comparer
L’annonce de Maia 200 publiée en janvier 2026 décrivait une puce fabriquée en 3 nm, dotée de 216 Go de HBM3e, d’une bande passante mémoire de 7 To/s et d’une enveloppe de 750 W. Microsoft explique désormais que cette génération sert déjà des charges de production et que les enseignements de son exploitation ont guidé Maia 300.
Le groupe indique déployer Maia 200 aux États-Unis, en Europe et en Australie. Pour certaines fonctions d’IA intégrées à Teams, Copilot et Cowork, il revendique jusqu’à 1,7 fois plus de jetons par watt que sur une infrastructure GPU de référence. Là aussi, il s’agit d’une mesure annoncée par Microsoft, qui ne suffit pas à décrire tous les modèles et tous les paramètres de service.
Cette distinction temporelle compte pour les utilisateurs. Les optimisations de Maia 200 peuvent déjà contribuer à l’infrastructure de certains services. Les bénéfices éventuels de Maia 300, eux, relèvent d’un déploiement à venir. L’annonce ne dit pas qu’une nouvelle version de Copilot sera immédiatement plus rapide ou moins chère pour chaque abonné à compter du 12 octobre.
Copilot, GitHub, Foundry : quels services pourraient en profiter ?
Microsoft cite Copilot comme charge déjà servie par Maia 200. GitHub Copilot et Microsoft Foundry doivent suivre d’ici la fin de 2026 sur cette génération, selon l’entreprise. Elle présente Maia 300 comme une base future pour des agents de programmation, l’hébergement de modèles dans Foundry, les travaux de l’équipe Microsoft AI et des interactions sensibles au temps de réponse, notamment dans Dragon Copilot.
Cette diversité explique pourquoi Microsoft insiste sur la souplesse de la plateforme. L’entreprise indique que Maia 200 exécute des modèles OpenAI, ses propres modèles MAI et des familles open source. Une infrastructure capable de servir plusieurs architectures évite de dépendre d’une seule famille de modèles, alors que les besoins de Copilot, du code, de la santé et des entreprises ne sont pas identiques.
Pour les clients, il faut toutefois distinguer le service accessible et le matériel utilisé en coulisse. Microsoft ne communique pas de prix public pour un accès direct à Maia 300, de liste de régions concernées par les premiers déploiements de 2027, ni de calendrier garantissant une baisse du prix de Copilot. Une meilleure efficacité interne pourrait aider le groupe à absorber la croissance des usages ; elle ne se traduit pas mécaniquement par une baisse de facture visible chez l’utilisateur.
Le pari industriel derrière les « plusieurs gigawatts »
En annonçant des déploiements de la famille Maia à une échelle de plusieurs gigawatts, Microsoft parle autant d’approvisionnement énergétique et d’aménagement de centres de données que de conception de puces. Il faut fabriquer les accélérateurs, les assembler en systèmes, installer les réseaux et assurer l’alimentation et le refroidissement. Le calendrier dépendra donc d’une chaîne industrielle plus large que la réussite d’un prototype.
Le contrôle d’une partie de cette chaîne donne à Microsoft une possibilité de co-concevoir le matériel et ses services. L’entreprise peut observer les charges réellement exécutées par Copilot et Foundry, puis ajuster mémoire, réseau et logiciels aux points de friction rencontrés. Cette intégration constitue un avantage stratégique plausible, mais son effet économique final devra être vérifié dans les déploiements réels.
Maia ne signifie pas non plus l’abandon des GPU. Microsoft décrit explicitement sa plateforme comme hétérogène et ouverte à plusieurs modèles et types de silicium. Pour certains besoins, un autre accélérateur pourra rester préférable. L’intérêt de Maia sera mesuré sur la part de charges qu’il peut servir efficacement, sans sacrifier la disponibilité, la flexibilité ou la qualité du service.
Ce qui reste à vérifier avant de parler de révolution
Le point décisif sera le passage de l’annonce à la production en 2027. Combien de racks Maia 300 seront réellement disponibles ? Sur quelles charges ? Avec quelle latence, quel taux d’occupation et quelle consommation mesurée à l’échelle de l’installation ? Ces réponses permettront de juger le gain opérationnel bien mieux qu’un seul ratio présenté lors du lancement.
Il faudra aussi observer si Microsoft publie des méthodologies de comparaison plus complètes et si des clients peuvent constater des effets tangibles dans Foundry ou les produits Copilot. Les chiffres internes sont utiles pour comprendre l’ambition du constructeur ; ils ne remplacent ni des tests reproductibles ni une expérience d’utilisation stabilisée.
Le regard FLUXAI : Maia 300 montre que la bataille de l’IA se déplace vers la capacité de servir des modèles et des agents en continu, dans une enveloppe électrique et financière soutenable. Microsoft a détaillé une architecture crédible et un plan industriel ambitieux. Mais l’actualité du 12 octobre est celle d’une annonce pour 2027, tandis que Maia 200 constitue la génération déjà déployée. La différence est essentielle pour apprécier la nouvelle sans confondre promesse technique et résultat acquis.
Sources principales
- Microsoft — annonce d’Azure Maia 300 et de la stratégie de déploiement, 12 octobre 2026.
- Microsoft Azure — présentation détaillée de l’architecture Maia 300, 12 octobre 2026.
- Microsoft — présentation de Maia 200, 26 janvier 2026.